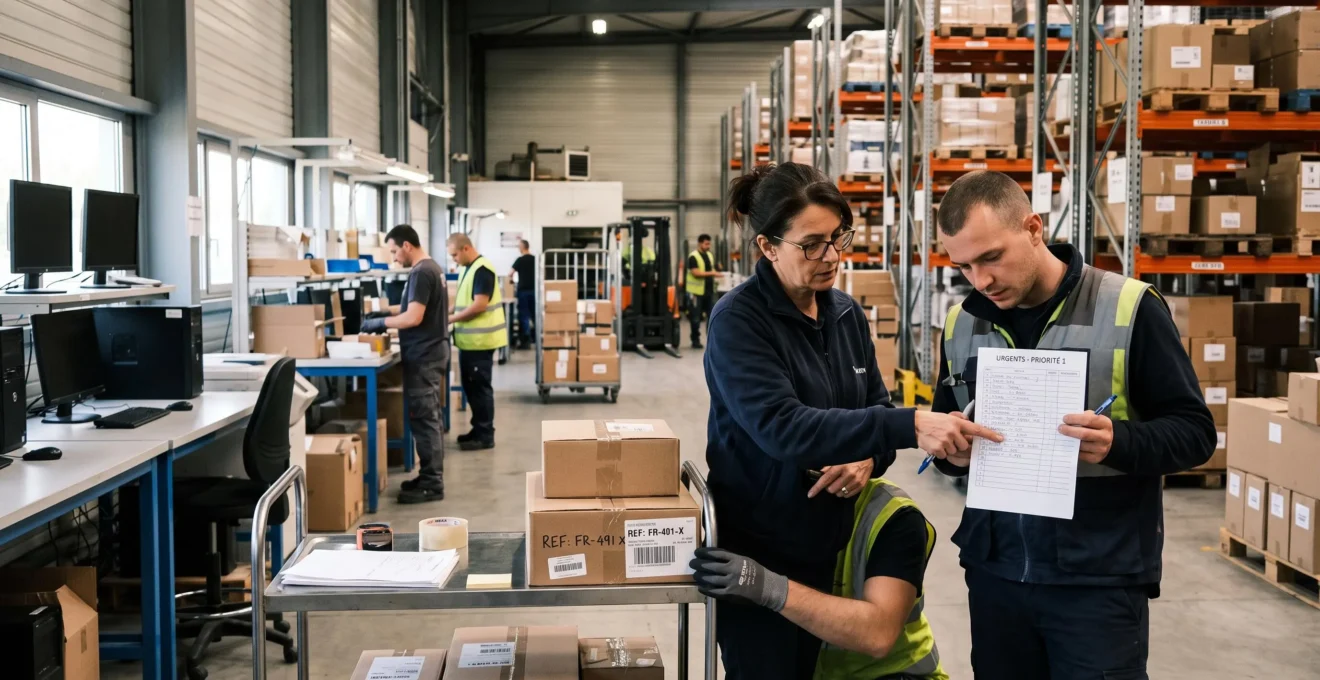
Une interruption majeure ne permet pas toujours de rétablir simultanément toutes les fonctions d’une entreprise. Une panne informatique, une cyberattaque, l’indisponibilité de collaborateurs clés ou la perte temporaire de locaux peuvent mobiliser des ressources limitées et désorganiser plusieurs services à la fois. Dans ces circonstances, la continuité opérationnelle consiste à déterminer quelles activités doivent reprendre en premier, avec quels moyens et sous quelles conditions.
La priorité ne dépend pas uniquement du chiffre d’affaires ou de la visibilité d’un service. Elle repose sur les conséquences d’une interruption, les dépendances entre activités, les obligations à respecter et les capacités réellement disponibles. Une fonction administrative ou informatique apparemment secondaire peut ainsi devenir indispensable au redémarrage d’un processus commercial.
Un dispositif efficace associe donc une analyse d’impact sur l’activité, une séquence de reprise documentée, des solutions de fonctionnement dégradé et des responsabilités clairement attribuées. L’objectif est de transformer une situation incertaine en décisions opérationnelles préparées, contrôlables et régulièrement vérifiées.
Les principes essentiels d’une reprise opérationnelle maîtrisée
- Hiérarchiser les activités selon les conséquences de leur interruption, leur durée maximale d’interruption acceptable et leur niveau minimal de service.
- Cartographier les dépendances humaines, techniques et organisationnelles pour construire un ordre de reprise réellement exécutable.
- Préparer des solutions de secours, des procédures adaptées à chaque rôle et des exercices permettant de vérifier les capacités de restauration.
- Pourquoi toutes les fonctions d’une entreprise ne doivent-elles pas être restaurées en même temps ?
- Comment définir un plan de reprise lorsque plusieurs services dépendent les uns des autres ?
- Mode dégradé ou arrêt complet : quelle solution privilégier après une panne majeure ?
- Comment réagir dès les premiers signes d’un ransomware sans aggraver l’incident ?
- Procédure courte ou fiche détaillée : quel format utiliser selon le rôle de chaque équipe ?
- Quelles erreurs rendent un plan de continuité inutilisable au moment d’une crise ?
- Comment former les équipes à la sécurité sans limiter l’apprentissage à des consignes théoriques ?
- Quand mettre à jour un plan de continuité après une transformation de l’entreprise ?
Pourquoi toutes les fonctions d’une entreprise ne doivent-elles pas être restaurées en même temps ?
Toutes les fonctions d’une entreprise ne doivent pas être restaurées simultanément, car leur interruption ne produit pas les mêmes conséquences. La reprise doit privilégier les activités dont l’arrêt menace la sécurité des personnes, les engagements essentiels, les obligations de l’organisation ou sa viabilité économique. Une analyse d’impact sur l’activité (BIA) permet de hiérarchiser ces besoins et de répartir les ressources disponibles selon leur criticité réelle.
La première étape consiste à identifier les processus indispensables au fonctionnement de l’organisation. Il faut ensuite évaluer les conséquences de leur indisponibilité dans le temps : retards de livraison, impossibilité de traiter des commandes, rupture d’approvisionnement, accumulation de dossiers ou incapacité à respecter des engagements contractuels.
Trois indicateurs permettent de formaliser les besoins :
- La durée maximale d’interruption admissible (DMIA) : durée au-delà de laquelle l’interruption d’une activité entraîne des conséquences jugées inacceptables.
- Le niveau de service minimum : capacité minimale à maintenir pour continuer à fournir une prestation essentielle.
- Les ressources indispensables : collaborateurs, équipements, applications, données, locaux et prestataires nécessaires au fonctionnement.
Ces indicateurs doivent être définis activité par activité. Une entreprise peut, par exemple, accepter de suspendre temporairement ses opérations commerciales secondaires, mais devoir maintenir le traitement des commandes déjà engagées. La hiérarchie doit également évoluer avec la durée de la crise : une activité initialement peu critique peut devenir prioritaire lorsque son indisponibilité bloque la facturation ou les approvisionnements.
Le guide du SGDSN pour réaliser un plan de continuité d’activité présente une méthodologie fondée sur l’identification des activités essentielles, l’évaluation des conséquences d’une interruption et la détermination des moyens nécessaires à leur maintien. Il distingue notamment la DMIA, la perte de données maximale admissible (PDMA) et la durée maximale de reprise technique prévue (DMRP). Ces notions répondent à des besoins différents et ne doivent pas être confondues.
La criticité d’une activité doit aussi être distinguée de celle de ses moyens de soutien. Une application d’authentification, un service administratif ou une fonction logistique peuvent devoir être restaurés avant une activité commerciale plus visible, simplement parce qu’ils conditionnent son fonctionnement.
Par exemple, une chaîne de traitement des commandes peut nécessiter un accès aux données clients, une vérification des stocks, une validation financière et une organisation logistique. Le redémarrage du service commercial ne suffit donc pas si les autres fonctions indispensables restent indisponibles.
Lorsque les ressources sont limitées, la direction doit arbitrer entre plusieurs demandes concurrentes. Elle peut notamment comparer les conséquences d’une reprise simultanée avec celles d’un rétablissement séquencé, en tenant compte des capacités humaines et techniques disponibles. Ces arbitrages doivent être préparés avant l’incident afin d’éviter que chaque responsable considère son propre service comme prioritaire.
3 indicateurs complémentaires
Le niveau de service minimum, la durée maximale d’interruption acceptable et les ressources indispensables structurent la définition des besoins de continuité. Ils constituent des repères méthodologiques, pas des seuils universels.
Méthodologie du guide PCA du SGDSN, édition 2013.
Une fois les activités prioritaires identifiées, leur rétablissement doit être organisé en tenant compte des moyens et des services dont elles dépendent.
Comment définir un plan de reprise lorsque plusieurs services dépendent les uns des autres ?
Un plan de reprise impliquant plusieurs services doit représenter les dépendances qui conditionnent réellement le fonctionnement des activités prioritaires. Il faut identifier les applications, les données, les compétences, les équipements, les locaux et les prestataires indispensables, puis organiser leur rétablissement dans un ordre cohérent. La séquence doit également prévoir des solutions de substitution et des critères précis pour passer d’une étape à l’autre.
La cartographie commence par les processus métiers, et non par un inventaire isolé des équipements informatiques. Pour chaque activité essentielle, il convient de remonter jusqu’aux ressources qui permettent de l’exécuter.
Une activité de préparation de commandes peut ainsi dépendre :
- De l’application de gestion commerciale et de son système d’authentification.
- Des données relatives aux clients, aux commandes et aux stocks.
- Des équipements réseau et des postes de travail.
- Des équipes chargées de la préparation et de l’expédition.
- Des transporteurs et des fournisseurs concernés.
Cette représentation permet de distinguer les dépendances bloquantes des dépendances contournables. Un système d’authentification peut être indispensable pour accéder à une application métier, tandis qu’un outil de reporting peut rester indisponible si les équipes disposent d’une méthode temporaire fiable pour suivre leurs opérations.
Cette distinction évite une erreur fréquente : attendre que l’intégralité du système d’information soit rétablie avant de relancer les activités qui pourraient fonctionner avec des moyens limités.
Les dépendances circulaires demandent une attention particulière. Deux services peuvent attendre mutuellement une validation, un fichier ou une intervention technique. Un prestataire unique peut également être sollicité par plusieurs fonctions simultanément. Dans ces situations, le plan doit désigner un responsable d’arbitrage, définir les informations minimales nécessaires au déblocage et prévoir une solution de remplacement lorsqu’elle est réaliste.
La séquence de reprise doit ensuite préciser les conditions de validation de chaque étape. Le redémarrage technique d’un serveur ne démontre pas, à lui seul, que le service métier fonctionne correctement. Il faut vérifier les accès, l’intégrité des données, la disponibilité des interfaces et la capacité effective des équipes à réaliser leurs opérations.
Les recommandations de l’ANSSI relatives à la sauvegarde des systèmes d’information insistent également sur l’importance de définir un ordre de restauration tenant compte des dépendances entre les composants techniques. La documentation de sauvegarde doit donc être reliée aux besoins métiers, plutôt que gérée comme un sujet informatique indépendant.
La version 1.1 du document Sauvegarde des systèmes d’information — Les fondamentaux, publiée le 27 novembre 2025, recommande notamment de tester régulièrement les sauvegardes et de mettre en œuvre des procédures de restauration. Elle rappelle également que la stratégie de sauvegarde doit tenir compte de la DMIA et de la PDMA définies pour les applications et les données métier.
3-2-1
L’ANSSI recommande trois copies distinctes des données, deux sauvegardes sur des supports différents et une sauvegarde hors ligne. Cette règle est une recommandation technique, non une obligation réglementaire universelle.
ANSSI, Sauvegarde des systèmes d’information — Les fondamentaux, version 1.1, 27 novembre 2025.
Pour rendre la séquence exploitable, chaque étape doit préciser un responsable, les prérequis, les opérations attendues et les critères de validation. Une étape peut par exemple être considérée comme terminée uniquement lorsque les accès sont disponibles, les données contrôlées et un test métier concluant.
Cette organisation doit également déterminer ce qui peut continuer à fonctionner lorsque les ressources nécessaires à une reprise nominale ne sont pas encore disponibles.
Mode dégradé ou arrêt complet : quelle solution privilégier après une panne majeure ?
Le mode dégradé est préférable lorsqu’une activité peut continuer avec des moyens réduits sans compromettre la sécurité, la fiabilité des données ou le contrôle des opérations. L’arrêt complet devient nécessaire lorsque les risques ne peuvent pas être maîtrisés, notamment en cas de perte de traçabilité indispensable ou de suspicion de compromission. Le choix doit donc dépendre des conditions réelles de fonctionnement, et non de la volonté de maintenir artificiellement l’activité.
Trois situations doivent être distinguées lors de la prise de décision :
| Situation | Conditions | Décision opérationnelle |
|---|---|---|
| Fonctionnement minimal | Les opérations restent contrôlables avec des moyens de secours. | Maintenir les activités essentielles sous restrictions. |
| Suspension partielle | Seules certaines opérations présentent un risque inacceptable. | Arrêter les opérations concernées et maintenir les autres si possible. |
| Arrêt complet | La sécurité ou la fiabilité globale ne peut plus être garantie. | Suspendre le processus jusqu’au rétablissement de conditions sûres. |
Le fonctionnement manuel constitue une solution de secours possible, mais il ne garantit pas automatiquement la continuité. Une commande enregistrée sur papier peut préserver la relation client tout en générant des doublons, des erreurs de stock ou des difficultés de rapprochement avec le système informatique.
Pour limiter ces risques, le dispositif doit prévoir des contrôles compensatoires : numérotation des documents, identification des personnes autorisées, suivi des opérations réalisées et plafonds de volume adaptés aux capacités de vérification. Les données provisoires doivent ensuite être rapprochées du système rétabli selon une procédure documentée.
Il existe également des situations dans lesquelles le mode dégradé doit être écarté. L’impossibilité de vérifier une information critique, une perte de traçabilité réglementaire ou un risque pour les personnes peuvent justifier une suspension. Une activité apparemment maintenue, mais dont les opérations ne sont plus fiables, peut aggraver les conséquences de l’incident.
La sortie du mode dégradé doit être préparée dès son activation. Elle nécessite un responsable habilité à autoriser le retour au fonctionnement nominal, des critères de validation technique et métier, ainsi qu’une méthode de traitement des opérations accumulées pendant l’interruption.
Il faut notamment vérifier que les systèmes restaurés sont suffisamment fiables, que les données provisoires sont cohérentes et que les éventuelles opérations en double ont été identifiées. Le retour à la normale ne se limite donc pas à la remise en service des équipements.
Lorsqu’une interruption est provoquée par une attaque informatique, ces arbitrages doivent être complétés par des mesures spécifiques de confinement et de sécurisation.
Comment réagir dès les premiers signes d’un ransomware sans aggraver l’incident ?
Face aux premiers signes d’un ransomware, l’entreprise doit déclencher rapidement son circuit d’alerte, faire appliquer les mesures de confinement prévues et préserver les éléments utiles à l’analyse. Les équipements suspects ne doivent pas être redémarrés, effacés ou restaurés de manière improvisée. Les décisions techniques sensibles doivent être confiées aux personnes compétentes, avant toute reconnexion ou reprise des activités concernées.
Les premiers indices peuvent prendre plusieurs formes : fichiers devenus illisibles, messages inhabituels, alertes de sécurité, comportements anormaux sur plusieurs postes ou indisponibilité soudaine de ressources partagées. Ces manifestations ne suffisent pas nécessairement à confirmer un rançongiciel, mais elles doivent déclencher une vérification rapide.
Le circuit d’alerte doit rester accessible lorsque les outils habituels sont indisponibles. Une messagerie professionnelle compromise ou inaccessible ne doit pas empêcher les collaborateurs de joindre les responsables désignés. Les coordonnées de secours et les moyens de communication alternatifs doivent donc être documentés à l’avance.
Le confinement consiste à limiter la propagation de l’incident. Selon la situation, les équipements ou segments suspects doivent être isolés du réseau, conformément aux consignes de réponse à incident. Les supports de sauvegarde doivent également être protégés contre une éventuelle compromission.
Le guide de l’ANSSI sur les attaques par rançongiciels recommande notamment d’isoler les équipements infectés et de préserver les sauvegardes. Il insiste également sur la nécessité de conserver une trace chronologique des événements et des actions entreprises.
Cette traçabilité peut prendre la forme d’une main courante indiquant, pour chaque événement, sa date, son heure, son auteur et sa description. Elle facilite la coordination des intervenants, le suivi des décisions et le retour d’expérience.
La restauration ne doit pas être déclenchée uniquement parce qu’une sauvegarde semble disponible. Il faut d’abord évaluer la portée de l’intrusion, vérifier la sécurité des comptes d’administration et déterminer si les environnements de restauration sont suffisamment protégés. Une sauvegarde peut contenir des éléments malveillants, notamment des implants ou des portes dérobées.
Le document technique de l’ANSSI consacré aux sauvegardes, dans sa version 1.1 du 27 novembre 2025, souligne également la nécessité de vérifier les données restaurées après un incident de sécurité. La disponibilité d’une copie ne démontre donc pas, à elle seule, son intégrité.
Les décisions cyber doivent enfin être coordonnées avec les responsables métiers. Il peut être nécessaire de suspendre certaines activités, de basculer vers des communications alternatives et de déterminer quelles opérations peuvent continuer sans exposer les systèmes encore sains.
Une attention particulière doit être portée aux obligations relatives aux données personnelles. Une panne informatique ne constitue pas automatiquement une violation de données personnelles. En revanche, lorsqu’une violation présentant un risque pour les droits et libertés des personnes est caractérisée, le responsable de traitement doit la notifier à la CNIL dans les meilleurs délais et, si possible, dans les 72 heures suivant sa constatation. La documentation interne reste nécessaire même lorsqu’aucune notification n’est requise. Le téléservice de la CNIL pour notifier une violation de données personnelles présente les modalités de cette démarche.
Les cinq premières actions à formaliser dans une procédure de réponse
- Identifier les premiers signes anormaux et déclencher le circuit d’alerte prévu : livrable vérifiable, une fiche de signalement indiquant l’événement, l’heure et le premier interlocuteur contacté.
- Appliquer les mesures de confinement adaptées par les personnes habilitées : livrable vérifiable, un relevé des équipements ou segments isolés et des décisions techniques prises.
- Préserver les informations utiles à l’analyse de l’incident : livrable vérifiable, une main courante chronologique indiquant les dates, heures, auteurs et descriptions des événements.
- Faire vérifier l’intégrité des sauvegardes et les conditions de restauration avant toute reconnexion : livrable vérifiable, un compte rendu de validation technique et de sécurité.
- Évaluer les conséquences métiers et les obligations applicables : livrable vérifiable, une décision documentée sur les activités suspendues, les solutions de secours et les éventuelles notifications à effectuer.
La reprise doit donc rester subordonnée à la maîtrise de l’incident. Restaurer trop tôt un environnement compromis peut réintroduire les éléments malveillants et compromettre les activités qui viennent d’être rétablies.
Pour que ces décisions soient appliquées correctement sous pression, chaque collaborateur doit disposer d’un support documentaire adapté à son rôle et à son niveau d’intervention.
Procédure courte ou fiche détaillée : quel format utiliser selon le rôle de chaque équipe ?
Une procédure courte convient aux collaborateurs qui doivent reconnaître un incident, effectuer un premier signalement et connaître les actions autorisées. Une checklist chronologique est plus adaptée aux responsables opérationnels chargés de coordonner les étapes de reprise. Les équipes techniques ont besoin de procédures détaillées décrivant les opérations sensibles, les prérequis et les contrôles à effectuer.
Un document unique de plusieurs dizaines de pages ne répond pas efficacement à toutes les situations. En période de crise, un collaborateur qui doit signaler une anomalie n’a pas besoin de consulter une procédure complète de restauration informatique. À l’inverse, une simple fiche réflexe ne fournit pas suffisamment de détails à un administrateur chargé de reconstruire un environnement technique.
Les supports doivent donc être différenciés selon les décisions attendues.
- Fiche réflexe : elle indique comment reconnaître une situation anormale, qui prévenir et quelles actions éviter.
- Checklist opérationnelle : elle décrit l’enchaînement des actions, les responsabilités et les validations nécessaires.
- Procédure technique : elle détaille les opérations de confinement, de restauration, de contrôle et de sécurisation.
Chaque support doit présenter des informations immédiatement exploitables : événement déclencheur, première action autorisée, actions interdites, interlocuteur à prévenir, solution de secours et critère d’escalade. Les formulations vagues telles que « prévenir le service compétent » ou « appliquer les mesures nécessaires » ne permettent pas de décider rapidement.
La documentation doit aussi rester accessible lorsque les systèmes habituels sont indisponibles. Des exemplaires imprimés ou des copies hors ligne peuvent être nécessaires, à condition d’être protégés contre les accès non autorisés. L’annuaire de crise doit être consultable indépendamment de l’infrastructure principale.
La gestion des versions constitue un autre point essentiel. Une procédure obsolète peut orienter les équipes vers un ancien prestataire, un numéro de téléphone inutilisable ou une application qui n’existe plus. Chaque document doit donc afficher son propriétaire, sa date de mise à jour et son statut de validité.
La qualité d’une procédure ne se mesure pas seulement à sa précision rédactionnelle. Elle se vérifie par une mise en situation dans laquelle les utilisateurs doivent retrouver seuls leur première action, leur interlocuteur et les limites de leur autorité.
Les difficultés observées constituent des indicateurs concrets : recherche trop longue, interprétation divergente, confusion entre les responsabilités ou incapacité à trouver une solution de secours. Ces observations doivent conduire à simplifier les supports ou à clarifier les décisions attendues.
Une procédure courte et une documentation détaillée ne sont donc pas concurrentes. Elles forment deux niveaux complémentaires d’un même dispositif de continuité, à condition que leurs consignes ne se contredisent pas.
Ces supports ne peuvent toutefois être efficaces que si les moyens annoncés et les responsabilités prévues existent réellement au moment de leur activation.
Quelles erreurs rendent un plan de continuité inutilisable au moment d’une crise ?
Un plan de continuité devient inutilisable lorsqu’il repose sur des ressources indisponibles, des délais irréalistes ou des responsabilités mal définies. Les hypothèses de reprise doivent être confrontées aux capacités réelles de l’entreprise : présence des collaborateurs, disponibilité des prestataires, accessibilité des solutions de secours et possibilité effective de restaurer les systèmes et les données.
Une première erreur consiste à supposer que les ressources critiques seront toujours disponibles. Un collaborateur clé peut être absent, un prestataire peut subir le même incident que son client ou un local de repli peut devenir inaccessible. Une sauvegarde peut également dépendre de l’infrastructure précisément touchée par la panne.
Chaque ressource essentielle doit donc être associée à une preuve de disponibilité et, lorsque cela est possible, à une solution alternative. Cette vérification concerne aussi bien les personnes que les équipements, les accès, les locaux et les contrats de prestation.
Une deuxième erreur est de fixer des objectifs de reprise sans vérifier les moyens nécessaires. Une organisation peut annoncer un rétablissement rapide tout en dépendant d’une capacité informatique insuffisante, d’un nombre trop faible de collaborateurs ou d’une intervention extérieure dont les délais n’ont jamais été testés.
Les objectifs doivent être confrontés à des essais mesurés. Il faut notamment vérifier si les sauvegardes peuvent être restaurées dans les conditions prévues, si les applications fonctionnent après rétablissement et si les équipes peuvent traiter les opérations prioritaires avec les ressources réellement mobilisables.
La gouvernance représente un troisième facteur de fragilité. Une crise peut être paralysée par l’absence de suppléant, un conflit entre responsables métiers et techniques ou une incertitude sur l’autorité habilitée à arrêter une activité. Les délégations de décision doivent être explicites, y compris en matière d’engagement de dépenses urgentes.
Enfin, une simple relecture documentaire ne constitue pas une démonstration de capacité opérationnelle. Un plan peut être parfaitement rédigé tout en étant impossible à exécuter parce qu’un numéro est erroné, qu’une restauration échoue ou qu’une solution manuelle n’a jamais été expérimentée.
Les exercices doivent donc vérifier des capacités concrètes. Ils peuvent notamment porter sur l’accès aux moyens de secours, la disponibilité d’un prestataire, la restauration d’une sauvegarde ou le traitement d’une commande en mode dégradé. Chaque difficulté observée doit donner lieu à une action corrective attribuée et suivie.
Cas pratique hypothétique : une solution de secours indisponible
Une entreprise prévoit de poursuivre le traitement de ses commandes grâce à une application hébergée chez un prestataire externe. Lors d’un exercice, elle découvre que les accès de secours nécessitent une authentification dépendant du système informatique principal, devenu indisponible dans le scénario.
Ce scénario pédagogique met en évidence une dépendance non maîtrisée. La correction consiste à revoir les modalités d’accès de secours, à désigner les personnes autorisées et à tester de nouveau la procédure avant de considérer le dispositif comme opérationnel. Il ne s’agit pas d’un incident réel documenté.
Pour chaque anomalie, le suivi doit préciser le risque associé, le responsable de correction, l’échéance interne et la preuve attendue. Un écart ne doit pas être considéré comme résolu uniquement parce qu’une modification documentaire a été réalisée : lorsque le problème concerne une capacité opérationnelle, un nouveau test est nécessaire.
Le plan gagne également à distinguer les hypothèses validées, les capacités non testées et les limites connues. Cette transparence permet à la direction de prendre des décisions réalistes plutôt que de s’appuyer sur une confiance excessive dans le dispositif.
Les simulations permettent précisément de révéler ces écarts, mais leur intérêt dépend de la manière dont les équipes sont préparées à prendre des décisions dans des situations incertaines.
À retenir avant de former les équipes
- Les collaborateurs doivent connaître leurs limites d’intervention autant que les actions qu’ils sont autorisés à réaliser.
- Les exercices doivent reproduire les contraintes opérationnelles susceptibles de perturber la coordination, et pas seulement vérifier la mémorisation des consignes.
- Chaque difficulté identifiée doit conduire à une amélioration documentée, suivie et vérifiée lors d’un nouvel exercice.
Comment former les équipes à la sécurité sans limiter l’apprentissage à des consignes théoriques ?
Les équipes apprennent à gérer une interruption en s’exerçant à prendre les décisions correspondant à leurs responsabilités. Les formations doivent donc associer des mises en situation, des procédures concrètes et des complications réalistes. L’objectif est de vérifier que les collaborateurs savent reconnaître un événement, transmettre les bonnes informations, appliquer les mesures autorisées et solliciter les personnes compétentes.
Un questionnaire de connaissances peut vérifier la mémorisation de certaines règles, mais il ne démontre pas la capacité à les appliquer sous contrainte. Une simulation permet d’observer des comportements opérationnels : réaction face à une panne, coordination entre services, respect des limites d’intervention ou transmission d’une information urgente.
Les scénarios doivent correspondre aux responsabilités des participants. Un collaborateur chargé de préparer des commandes doit savoir utiliser les supports de secours et signaler une incohérence. Un responsable opérationnel doit pouvoir arbitrer les priorités et coordonner les ressources. Un administrateur informatique doit connaître les procédures techniques correspondant à ses habilitations.
Les exercices gagnent en réalisme lorsqu’ils introduisent progressivement des complications :
- Un responsable habituellement sollicité devient temporairement injoignable.
- Les outils de communication habituels ne fonctionnent plus.
- Les informations reçues par deux services sont contradictoires.
- Un prestataire annonce qu’il ne peut pas intervenir dans les conditions prévues.
- Une opération de secours nécessite une validation qui n’est pas immédiatement disponible.
Ces situations permettent d’observer si les équipes savent utiliser les circuits d’escalade et les solutions de substitution sans dépasser leurs habilitations. Elles mettent également en évidence les procédures qui dépendent excessivement d’une personne ou d’un outil unique.
La mesure des résultats doit être adaptée au rôle de chaque participant. Plusieurs indicateurs peuvent être suivis :
- La capacité à reconnaître un événement nécessitant une escalade.
- L’exactitude des informations transmises aux interlocuteurs compétents.
- Le respect des limites d’intervention et des actions interdites.
- La capacité à appliquer une solution de secours autorisée.
- La qualité des décisions prises lorsque les informations sont incomplètes.
La qualité de l’apprentissage dépend aussi du retour d’expérience. Après chaque simulation, les participants et les observateurs doivent examiner les écarts entre les procédures prévues et les pratiques constatées. L’objectif est d’identifier les difficultés organisationnelles et documentaires sans rechercher systématiquement une responsabilité individuelle.
Les actions correctives doivent être attribuées à des responsables et faire l’objet d’un suivi. Une nouvelle simulation permet ensuite de vérifier si les difficultés ont réellement disparu. Cette démarche transforme la formation en amélioration continue de la capacité de reprise.
Une organisation peut également conserver un historique des exercices, des scénarios utilisés, des participants, des décisions prises et des résultats observés. Ces informations facilitent la comparaison entre les sessions et permettent de cibler les formations complémentaires nécessaires.
Pour conserver cette capacité dans le temps, les exercices et les procédures doivent toutefois rester cohérents avec l’organisation réelle de l’entreprise, notamment lorsque ses activités ou ses outils évoluent.
Quand mettre à jour un plan de continuité après une transformation de l’entreprise ?
Un plan de continuité doit être réexaminé dès qu’une transformation modifie les activités prioritaires, les ressources indispensables, les responsabilités ou les dépendances de l’entreprise. Un changement d’ERP, une migration cloud, une externalisation, une acquisition ou une réorganisation peuvent rendre certaines procédures obsolètes. La révision doit alors être proportionnée à l’ampleur du changement et accompagnée de vérifications opérationnelles.
Une révision uniquement calendaire ne suffit pas à maintenir un dispositif fiable. Une modification importante peut intervenir quelques semaines après une mise à jour documentaire et rendre immédiatement inexactes certaines hypothèses de reprise.
Les événements déclencheurs doivent donc être identifiés dans le processus de conduite du changement :
- Migration d’un système informatique ou changement d’ERP.
- Transfert d’une activité à un prestataire externe.
- Acquisition, fusion ou réorganisation de l’entreprise.
- Changement de locaux ou modification des capacités logistiques.
- Évolution des effectifs, des compétences ou des responsabilités critiques.
- Modification d’un fournisseur ou d’un partenaire indispensable.
Tous les changements ne nécessitent cependant pas le même niveau de réexamen. La modification des coordonnées d’un suppléant peut justifier une actualisation documentaire limitée. Le remplacement d’un prestataire essentiel peut imposer une nouvelle analyse des dépendances, des délais d’intervention et des solutions de substitution.
Une transformation majeure du système d’information peut, quant à elle, remettre en question l’ensemble des conditions de restauration : architecture technique, accès administratifs, sauvegardes, ordre de redémarrage et compétences nécessaires. Une nouvelle analyse d’impact peut alors être nécessaire.
La continuité opérationnelle doit être intégrée aux étapes de validation d’un projet. Avant la mise en production d’une nouvelle application ou le transfert d’un processus, il faut vérifier que les accès de secours sont fonctionnels, que les sauvegardes sont exploitables et que les responsabilités sont clairement attribuées.
Lorsque cela est possible, les conditions de retour arrière doivent également être définies. Il convient notamment de préciser les critères qui justifient une annulation de la mise en production, les personnes autorisées à prendre cette décision et les moyens nécessaires pour rétablir une configuration antérieure.
Le suivi de validité du plan repose enfin sur une gouvernance documentaire. Chaque composante critique doit avoir un propriétaire clairement identifié, chargé de signaler les évolutions et de maintenir les informations pertinentes à jour.
Un registre de modifications permet de conserver la trace des changements, des documents concernés et des contrôles réalisés. Les actions de mise à jour doivent être considérées comme terminées uniquement lorsque les vérifications adaptées ont été effectuées. Une modification technique importante doit notamment être suivie d’un test de restauration ou d’une simulation appropriée.
Le guide du SGDSN publié en 2013 présente une méthodologie de maintien et d’amélioration du plan de continuité. Ses recommandations doivent être replacées dans leur contexte historique et adaptées aux évolutions techniques, organisationnelles et réglementaires intervenues depuis sa publication.
Le maintien en conditions opérationnelles ne signifie donc pas réécrire intégralement le plan à chaque changement. Il consiste à identifier les éléments affectés, à réexaminer les hypothèses concernées et à démontrer que les procédures modifiées restent exécutables.
La continuité opérationnelle devient ainsi une capacité durable de l’organisation : les activités essentielles sont identifiées, les décisions sont préparées, les solutions de secours sont testées et les changements sont intégrés au dispositif. Pour engager cette démarche, la première étape consiste à faire valider par la direction une analyse d’impact sur les activités prioritaires, puis à désigner les responsables chargés de transformer ses conclusions en procédures et en exercices vérifiables.
Quelle est la différence entre un plan de continuité d’activité et un plan de reprise d’activité ?
Le plan de continuité d’activité (PCA) organise le maintien des activités essentielles pendant une perturbation, éventuellement avec des moyens dégradés. Le plan de reprise d’activité (PRA) décrit plus spécifiquement les dispositions permettant de rétablir les ressources et les services nécessaires après une interruption. Les deux démarches sont complémentaires : la continuité vise à limiter les conséquences de l’arrêt, tandis que la reprise organise le retour progressif aux conditions de fonctionnement attendues.
Comment déterminer quelles activités doivent être reprises en premier ?
La priorité doit être déterminée à partir d’une analyse d’impact sur l’activité. Celle-ci examine les conséquences d’une interruption, la durée maximale acceptable, le niveau minimal de service et les ressources indispensables. Il faut également prendre en compte les dépendances : une fonction de soutien peut devoir être rétablie avant une activité plus visible lorsqu’elle conditionne son fonctionnement.
À quelle fréquence faut-il tester un plan de continuité ?
La fréquence dépend de la criticité des activités, des changements organisationnels et des risques identifiés. Le guide PCA du SGDSN, publié en 2013, recommande de tester les éléments critiques au moins une fois par an. Cette indication constitue une recommandation historique de ce guide, et non une obligation réglementaire générale. Des tests supplémentaires sont pertinents après une transformation importante ou lorsqu’une faiblesse opérationnelle est identifiée.
Peut-on poursuivre une activité sans accès au système informatique principal ?
Oui, si une solution de secours a été préparée et permet de conserver un niveau de contrôle suffisant. Le fonctionnement manuel ou hors ligne doit être encadré par des règles de traçabilité, des limites de volume, des responsabilités et une méthode de rapprochement des données après rétablissement. Si la fiabilité des opérations ou la sécurité ne peuvent plus être garanties, une suspension temporaire est préférable.
Une entreprise doit-elle notifier la CNIL après chaque incident informatique ?
Non. Une panne informatique ne déclenche pas automatiquement une notification à la CNIL. Cette obligation concerne les violations de données personnelles présentant un risque pour les droits et libertés des personnes. Le responsable de traitement doit alors notifier l’autorité dans les meilleurs délais et, si possible, dans les 72 heures après avoir pris connaissance de la violation. Les violations doivent être documentées en interne, y compris lorsqu’elles ne nécessitent pas de notification.